CopyRight 2009-2020 © All Rights Reserved.版权所有: 中国海关未经授权禁止复制或建立镜像
基于可变卷积的YOLOv8口岸火灾防控技术研究
作者:王 涵 费立蜀 陈 维 胡首鹏 张彩丽
王 涵 费立蜀 陈 维 胡首鹏 张彩丽
王 涵 1 费立蜀 1 陈 维 1 胡首鹏 1 张彩丽 1
摘 要 本研究针对口岸火灾防控目标检测中常见的形状畸变与尺度多样性的问题,提升传统固定卷积适配复杂场景的能力,开展基于可变卷积的YOLOv8技术优化研究。通过将可变卷积(Deformable Convolutional,DCN)引入YOLOv8的头部层,动态调整卷积核采样位置,从而增强模型对复杂形状目标的特征捕捉能力。实验结果表明,改进后的YOLOv8-DCN模型在火焰、烟雾等目标检测任务中,火焰类别mAP50、mAP50-95分别提升7.2%和12.6%,烟雾类别检测精度也有所提升,且检测时延仅增加7.3%,兼顾了检测的高精度与实时性。本研究为YOLOv8技术应用于复杂场景检测提供了优化方向,其轻量化与高效性的特性适配海关在口岸、堆场等监控场景的火灾防控需求,可为提升口岸应急响应速度与监管智能化水平提供技术支撑。
关键词 可变卷积;YOLOv8;复杂形状
Research on Port Fire Prevention and Control Technology of YOLOv8 Based on Deformable Convolution
WANG Han1 FEI Li-Shu1 CHEN Wei1 HU Shou-Peng1 ZHANG Cai-Li1
Abstract Based on the common status of shape distortion and scale diversity in object detection for port fire prevention and control, this study aims to improve the adaptability of traditional fixed convolution to complex scenarios, and carries out research on the technical optimization of YOLOv8 based on deformable convolution. The research method is to introduce deformable convolutional networks (DCN) into the head layer of YOLOv8, which enhances the model's feature capture capability for targets with complex shapes by dynamically adjusting the sampling positions of the convolution kernel. Experimental results show that in the object detection tasks of flame, smoke and other targets, the improved YOLOv8-DCN model achieves a 7.2% and 12.6% increase in mAP50 and mAP50-95 for the flame category respectively, and the detection accuracy for the smoke category is also improved. Meanwhile, the detection latency only increases by 7.3%, balancing high accuracy and real-time performance of detection. This study provides an optimization direction for YOLOv8 in complex scene detection, and its lightweight and high-efficiency characteristics are suitable for the fire prevention and control needs of the Customs in monitoring scenarios such as ports and storage yards, thus providing technical support for improving the emergency response speed of ports and the intelligent level of supervision.
Keywords deformable convolution; YOLOv8; complex shape
第一作者:王涵(1997—),男,汉族,山东青岛人,硕士,主要从事业务运行监控工作,E-mail: 1395724712@qq.com
1.日照海关 日照 276800
1. Rizhao Customs, Rizhao 276800
火灾监控中的关键对象如火焰、烟雾等具有形态不规则、动态变化显著的特征,其中火焰存在弥散轮廓、闪烁不定的特点,烟雾则呈现边缘模糊、扩散无规律的属性,这些复杂特征对目标检测技术的精准识别能力提出了挑战。传统目标检测模型中广泛应用的固定卷积,采用等间隔采样模式,采样位置与核形状固定,难以适配火焰、烟雾等目标的动态形变与不规则形态,导致特征捕捉不充分,另外检测模型的轻量化、实时性也有待改进。
针对海关监管的场景特性与技术需求,亟需构建一种兼具精准识别能力与工程实用性的目标检测方案。本研究聚焦这一核心需求,探索将可变卷积[1]与YOLOv8模型相结合的优化路径,以期提升海关监管场景应用效能。
1 YOLOv8技术介绍
1.1 YOLOv8 简介
YOLOv8是YOLO系列迭代模型,继承YOLOv5高效检测框架,通过架构优化与算法创新,显著提升了检测速度与精度,在多尺度目标检测、复杂场景适应性等方面实现系统性改进,是实时目标检测领域的核心技术方案,为海关监控场景提供了兼具理论与工程价值的基础模型。
1.2 YOLO网络结构
YOLOv8采用“骨干层—颈部层—头部层”三级架构,三者协同实现高精度实时目标检测。骨干层通过分流融合减少计算冗余,搭配空间金字塔快速池化模块(Spatial Pyramid Pooling–Fast,SPPF)[2]串行大尺寸池化核实现高效多尺度特征融合;颈部层结合特征金字塔网络(Feature Pyramid Network,FPN)[3]与路径聚合网络(Path Aggregation Network,PAN)[4]的双向路径,完成高低层特征深度交互,兼顾小目标检测与大目标定位精度;头部层分离分类与检测任务,直接预测目标坐标与类别,规避锚框设计复杂性。该架构支持多尺度输出,可集成可变卷积适配不规则目标,在保持高效推理的同时,提升了检测精度、鲁棒性与泛化能力。
1.2.1 骨干层
骨干层以C2f模块[5]为核心,结合卷积(Conv2d)、批归一化(BatchNorm2d)[6]及 SiLU[7]激活函数构建,通过残差连接与结构重参数化优化计算效率,搭配深度可分离卷积、膨胀卷积增强特征提取能力。SPPF模块通过串行大尺寸池化核实现多尺度特征融合,降低计算支出。
SiLU是一种常见的激活函数,其函数图像如图1所示。SiLU 激活函数存在确定的下界,函数值不会随输入变化无限制降低,其值域在上方向则无明确上界,可随输入增大持续递增,同时该函数具备处处连续可微的特性,整体曲线变化平滑,梯度过渡无突变,能有效避免优化过程中出现梯度震荡问题。SiLU函数计算见公式(1),其中x为输入值。
(1)
C2f模块的简易结构如图2所示。C2f模块采用卷积处理输入,生成结果特征。该特征被分为两路:一路直接连接至输出端的拼接层,另一路通过包含卷积、标准化和激活函数的瓶颈结构进行特征增强,最终两路特征在拼接层融合。
1.2.2 颈部层
融合FPN与PAN网络,通过自顶向下与自底向上的双向路径实现不同尺度特征深度交互,既强化低层细节特征以优化小目标检测,又聚合高层语义信息以提升大目标定位精度,同时集成C2f模块与Concat模块进一步增强特征表达。
1.2.3 头部层
分离分类与检测任务,分类分支独立预测类别概率,检测分支直接回归目标坐标与宽高,规避锚框设计复杂性;支持多尺度输出,可集成可变卷积动态调整采样方式,增强对不规则目标的适应性。
2 可变卷积技术介绍
卷积作为深度学习核心运算单元,凭借局部感知与参数共享特性,搭建像素到语义的层次化表征桥梁,是目标检测、图像识别的技术基石。其贯穿特征提取、多尺度感知等流程,直接影响神经网络的精度、效率与泛化能力,凭借自身优势为智能安防、自动驾驶等领域提供可靠算法支撑,且随着可分离卷积、动态卷积等变体发展,持续拓展复杂场景应用边界。
2.1 卷积技术介绍
传统卷积是卷积神经网络(Convolutional Neural Networks,CNN)中提取局部特征的核心操作,其过程可简单概括为滑动、相乘、求和。
图3所示为输入特征图上进行普通卷积操作的过程,采用大小为3×3的卷积核(Kernel),在尺寸为5×5像素的输入特征图(Input)上做卷积操作,卷积核的权重与输入特征图相应位置元素按一一对应关系,逐个相乘后累加,即可得到输出特征图上的元素。对于输入特征图上任意一点,卷积操作可表示为:
(2)式(2)中,y为输出,w为卷积权重值,x为输入值。
2.2 可变卷积技术原理
传统卷积的卷积核尺寸与结构固定,在处理形状不变的物体时表现较好,却难以适应火焰、烟雾等形态多变的对象;而可变卷积的采样位点更贴合形状多变物体。可变卷积引入可变采样位置,通过学习训练使其贴近物体形状。
在可变形卷积中加入偏移量参与计算,偏移量综合考虑输入和卷积结果。可变卷积计算见公式(3):
(3)式(3)与式(2)的差别在于偏移量。作为非整数,难以对应到输入图片中实际存在的像素点,因此需要使用插值来得到偏移后的像素值。比较典型的方式是双线性插值:把插值点像素的值视为其周围的4个最近存在的实际像素点的加权平均值,每个点的权重取决于它与插值点之间水平方向和垂直方向的距离,并且插值点距离这四个领域点不超过一个像素。
2.3 可变卷积技术用于YOLOv8
YOLOv8支持目标检测、实例分割与姿态估计[8]的多任务联合学习,其检测头需同时输出边界框、掩码与关键点坐标。传统固定卷积的规则采样难以同时满足不规则物体的空间精度需求,可以引入可变卷积技术进行优化。
可变卷积主要用于替换头部层的分类头,经过实验测试,可变卷积在YOLOv8检测头中的成功源于其动态适应目标尺度、形状和位置的能力,与检测头的精细化定位需求高度契合。而在Backbone和Neck中,标准卷积的高效性、稳定性和轻量化优势更为突出。
3 效果对比
为验证可变卷积对YOLOv8在火焰、烟雾识别任务中的性能提升,本研究设计了对比实验,针对检测精度、多尺度适应性展开分析。实验数据基于火焰、烟雾数据集(VOCdevkit 2007),对比模型为原始YOLOv8(原始模型)与改进的YOLOv8-DCN(引入可变卷积的改进模型)。
3.1 实验环境
3.1.1 硬件环境
8GB显存显卡、Intel i7-12700F、32 GB DDR4内存。
3.1.2 软件环境
Python 3.8.8、Conda 23.7.4、Pytorch 1.13.1、YOLOv8官方库。
3.2 PASCAL VOC DevKit 数据集概述
PASCAL VOC(Visual Object Classes)DevKit 数据集是计算机视觉领域重要的基准数据集,由欧盟 PASCAL(Pattern Analysis,Statistic Machine Learning and Computational Learning)项目于 2005 年首次发布,致力于提供标准化的目标检测、图像分类、语义分割等任务评测平台。其规范的标注格式与多任务支持特性,使其成为早期深度学习模型(如 R-CNN[9]、YOLOv1[10])的核心验证数据集。
3.3 实验结果
本研究对于火焰、烟雾目标使用YOLOv8原始模型和经过可变卷积优化的YOLOv8模型进行了性能效果对比,结果见表1。
火焰mAP50提升7.2%,目标边界模糊,可变卷积通过动态采样贴合火焰的弥散轮廓,降低了因形状不匹配导致的漏检。mAP50-95提升12.6%,可变卷积通过调整采样点捕捉火焰的不规则边缘,提升了精细定位能力。另外,应用了可变卷积将YOLOv8的检测时间从4.1 ms增至4.4 ms,增幅仅有7.3%,实时性依旧有保障,满足海关通道实时监控需求。
3.4 识别效果
本模型设计用于口岸场景,在口岸场景中的使用效果如图3所示。模型在实验测试中能够较好地识别出火焰、烟雾等核心检测目标,即便在集装箱、车辆等多目标物体的复杂场景下,该模型也能实现对画面中火焰、烟雾目标的精准识别与有效检出。
4 结语
本研究聚焦口岸火灾防控的实际需求与技术问题,提出可变卷积与 YOLOv8 深度融合的针对性技术方案,通过精准的架构优化与场景化适配,实现了检测性能与工程实用性的提高。
从技术方案设计逻辑来看,本研究立足海关监管场景核心要素:一方面,码头堆场、仓储库区等环境中,火焰、烟雾等目标存在形态不规则、动态变化的特征,传统固定卷积的等间隔采样模式难以精准捕捉其关键特征;另一方面,海关监控设备多为嵌入式终端,对模型轻量化与实时性要求严苛。为此,本研究方案仅将可变卷积引入YOLOv8的头部层分类头,利用其动态调整采样位置与核形状的特性,有针对性强化不规则目标的特征捕捉能力,同时完整保留 YOLOv8骨干层、颈部层的高效架构,避免全网络替换导致的计算量激增。这一设计既发挥了可变卷积对复杂形状目标的适配优势,又保证了运行效率。
实验结果验证了技术方案的有效性:改进后的YOLOv8-DCN模型,火焰目标mAP50提升7.2%,mAP50-95提升12.6%,解决了固定卷积对火焰弥散轮廓、细小火光等特征捕捉不足的问题。同时,检测时延仅从4.1 ms增至4.4 ms,增幅7.3%,可满足该实验场景下实时监控时效要求。
综上所述,本研究的技术方案不仅解决了传统固定卷积在复杂形变与多尺度目标检测中的性能问题,更通过场景化的架构优化,实现了精度、轻量、稳定的三者兼顾。该方案既为YOLOv8模型在复杂场景下的优化提供了精准适配而非全盘重构的有效思路,也为口岸智能防火监控提供了技术方案,为实时目标检测技术与海关监管业务的融合提供了理论与实践参考。
参考文献
[1] Chen F, Wu F, Xu J, et al. Adaptive deformable convolutional network[J]. Neurocomputing, 2021: 453: 853-864.
[2] He K, Zhang X, Ren S, et al. Spatial Pyramid Pooling in Deep Convolutional Networks for Visual Recognition[J]. IEEE Transactions on Pattern Analysis and Machine Intelligence, 2015, 37(9): 1904-1916.
[3] Lin T Y, Dollár P, Girshick R, et al. Feature pyramid networks for object detection[J]. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2017: 2117-2125.
[4] Liu S, Qi L, Qin H, at al. Path aggregation network for instance segmentation[J]. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2018: 8759-8768.
[5] Wang L, Wang Z, Zhao X, et al. Enhanced Research on YOLOv12 Detection of Apple Defects by Integrating Filter Imaging and Color Space Reconstruction[J]. Electronics, 2025, 14(21): 4259. DOI:10.3390/electronics14214259.
[6] Ioffe S, Szegedy C. Batch normalization: Accelerating deep network training by reducing internal covariate shift[J]. In International Conference on Machine Learning, 2016(6): 448-456.
[7] Paul A, Bandyopadhyay R, Yoon J H, et al. SinLU: Sinu-sigmoidal linear unit[J]. Mathematics, 2022, 10(3): 337. DOI:10.3390/math10030337.
[8] Xu X, Wu T, Du Z, et al. Enhanced human pose estimation using YOLOv8 with Integrated SimDLKA attention mechanism and DCIOU loss function: Analysis of human body behavior and posture[J]. PLoS One, 2025, 20(5): e0318578. DOI:10.1371/journal.pone.0318578.
[9] Girshick R, Donahue J, Darrell T, at al. Rich feature hierarchies for accurate object detection and semantic segmentation[J]. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2014: 580-587.
[10] Redmon J, Divvala S, Girshick R, et al. You only look once: Unified, real-time object detection[C]//Proceedings of the IEEE conference on computer vision and pattern recognition. 2016: 779-788.
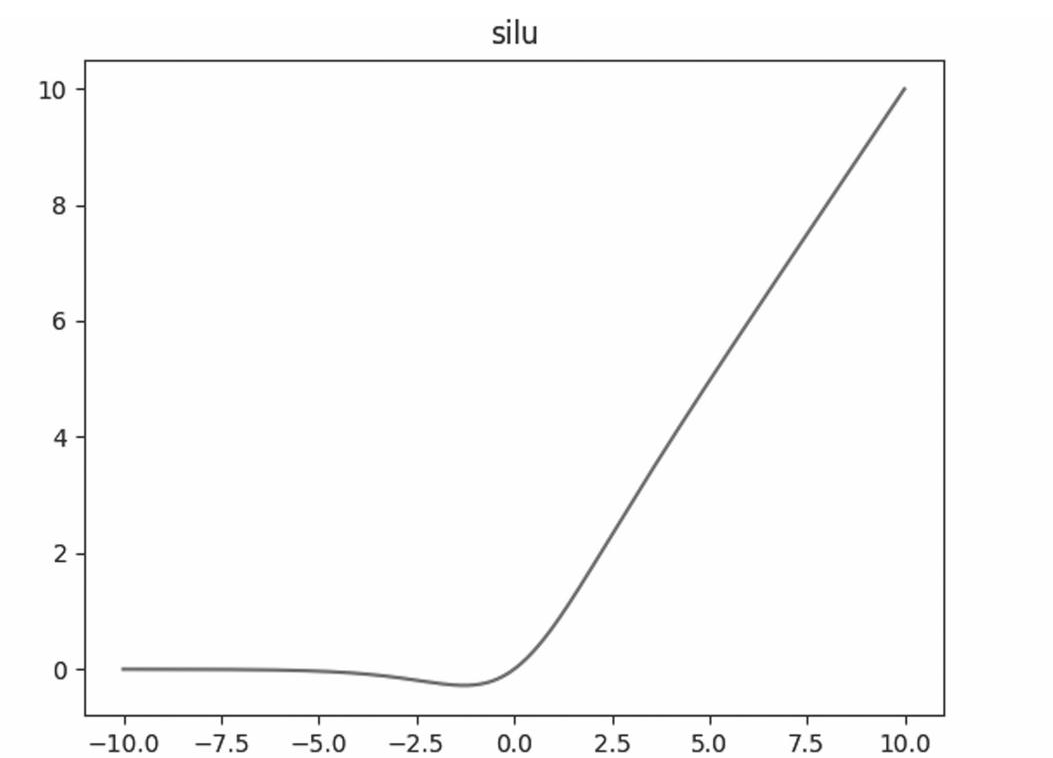
图1 SiLU函数曲线
Fig.1 Graph of the SiLU function
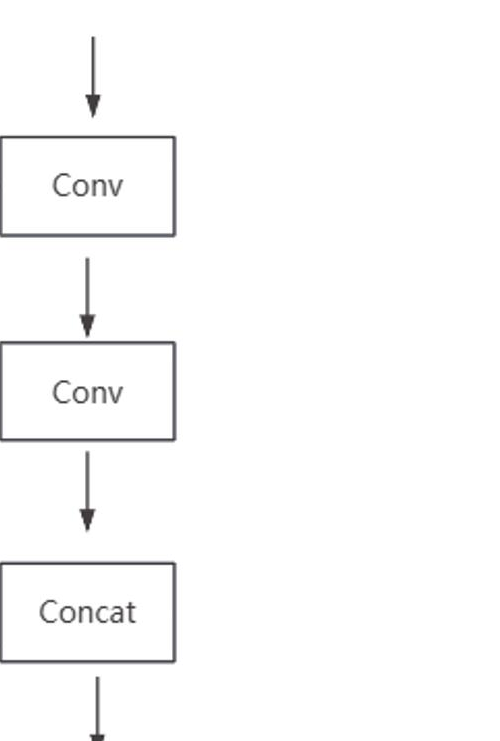
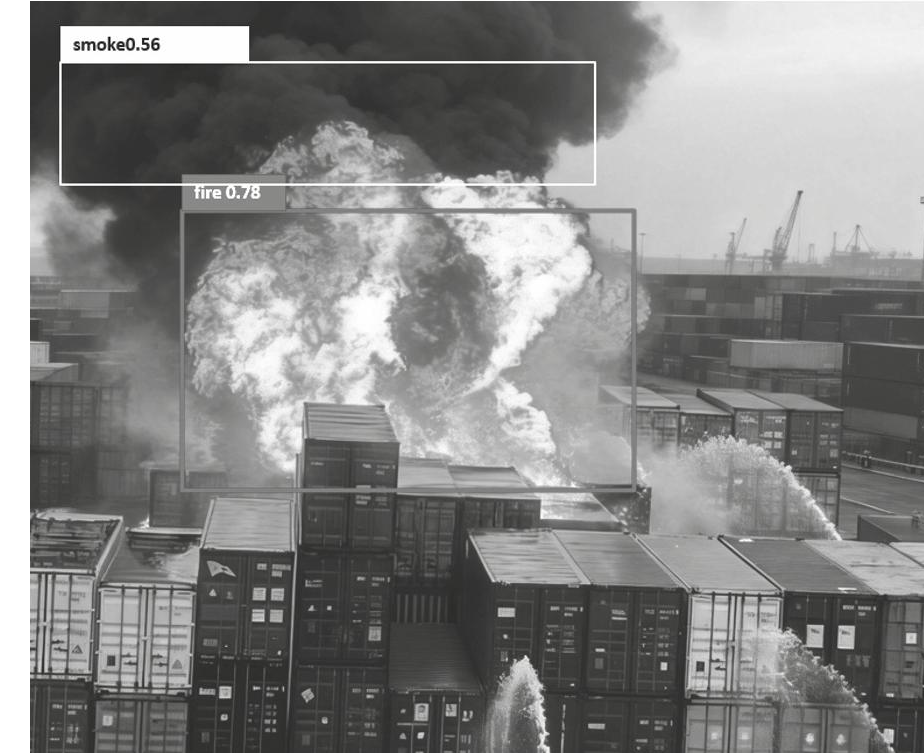
图2 C2f模块的简易结构图
Fig.2 Simplified structure diagram of the C2f module
图3 火焰、烟雾识别效果图
Fig.3 Recognition effect diagram of flame and smoke
表1 原始模型与改进模型在火焰、烟雾识别中的性能效果对比
Table 1 Effect comparison of the original model and improved model in flame and smoke recognition
类别火焰原始模型烟雾原始模型其他原始模型火焰改进模型烟雾改进模型其他改进模型
精准率0.6040.6060.4210.6680.640.445
mAP500.6340.5190.3120.680.5210.319
mAP50-950.3670.3020.1580.4120.3030.168